
- Регистрация
- 13.04.2019
- Сообщения
- 911
- Реакции
- 593
- Баллы
- 93
Всех приветствую, на связи Brabus!
Если базовых навыков пока нет, то можете сперва изучить другие мои статьи:
Начинаем кодить на c# (часть 1). Основы.
Начинаем кодить на с# (часть 2). Что такое ООП? Принципы ООП. Примеры для Zennoposter.
Я занимаюсь email-рассылками и часто сталкиваюсь с задачами, которые выходят за рамки стандартных кубиков Zennoposter, но хорошо решаются с помощью кода. В этот раз столкнулся с задачей: нужно распаковать много архивов с PDF-файлами и спарсить их содержимое, и на основе полученных данных делать уже другие задачи.
Скорее всего, опытные email-траферы понимают, зачем именно иногда нужно заглянуть внутрь PDF-файлов (может быть и не своих?), а в моём случае их ещё сперва нужно доставть из zip-архивов.
Библиотеку можно нагуглить или обратиться к ИИ. В этот раз мне было немного некогда гуглить и GPT-шить готовые библиотеки, поэтому я пользовался тем, что уже было под рукой. Библиотека Chilkat идёт в комплекте с Zennoposter (по-моему до сих пор идёт в комплекте) и частенько используется email-разработчиками, включая меня, т.к. в этой библиотеке есть полезные методы для работы с почтой.
Например, у себя в проектах с помощью этой библиотеки я отслеживаю попадание писем в инбокс или спам на контрольных почтах.
Данный код заглядывает внутрь библиотеки и построчно показывает её содержимое.
Сделаю пару комментарием для лучшего понимания. В этом коде:
1) Assembly - это класс внутри пространства имён System.Reflection, который позволяет работать с .NET-сборками в формате .dll (библиотеками).
Отсюда получаем конструкцию System.Reflection.Assembly
2) LoadFrom - метод, который загружает .NET-сборку из файла .dll. После этого мы можешь посмотреть классы и методы внутри библиотеки.
Отсюда получаем конструкцию System.Reflection.Assembly.LoadFrom(@"тут_путь_до_библиотеки");
3) foreach - цикл с удобной конструкцией для перебора всего содержимого (элементов\объектов) в массивах и коллекциях.
Это аналог цикла for, но не нужно указывать сколько итераций (шагов) нужно сделать.
4) У класса Assembly есть метод GetTypes(), с помощью которого можно получить коллекцию с типом данных Type.
Отсюда получаем конструкцию Type type in assembly.GetTypes().
5) Отсюда получаем конструкцию foreach (Type type in assembly.GetTypes())
Простыми словами: "Поочередно возьми все типы из библиотеки и записывай тип в переменную type"
6) И если тип является классом:
if (type.IsClass)
7) То выведи его название в ЛОГ:
project.SendInfoToLog($"Нашли класс: {type.FullName}");
Простым языком, мы сделали следующее:
Подгрузили библиотеку Chilkat.
Распаковали её.
Поочередно вывели в ЛОГ название всех классов.
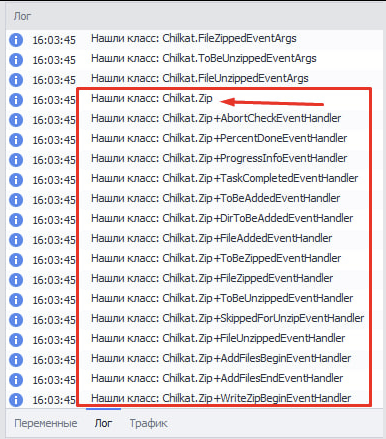
И бинго! В ЛОГе мы видим что-то связанное с zip-архивами Chilkat.Zip:
Заглядываем внутрь zip-архива с помощью c#Это означает, что можно продолжать в этом направлении. Теперь давайте посмотрим, какие методы доступны у найденого класса Chilkat.Zip
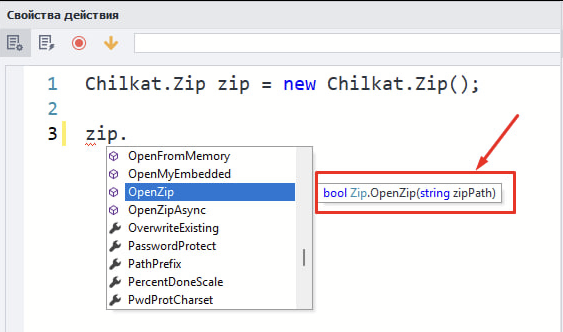
Для этого в кубике c# создадим объект класса Chilkat.Zip и посмотрим через знак точки, какие методы нам доступны. Банальным просматриваем я натыкаюсь на метод zip.OpenZip, который еще и на вход принимает путь к архиву zipPath.
На всякий случай я убедился, что это то, что нам нужно. Благо, что у разработчиков баблиотеки есть очень подробные мануалы:
https://www.chilkatsoft.com/refdoc/xChilkatZipRef.html#OpenZip
Давайте теперь протестируем найденный метод zip.OpenZip и попробуем с помощью него вывести в ЛОГ содержимое архива. Для этого выполним короткий код:
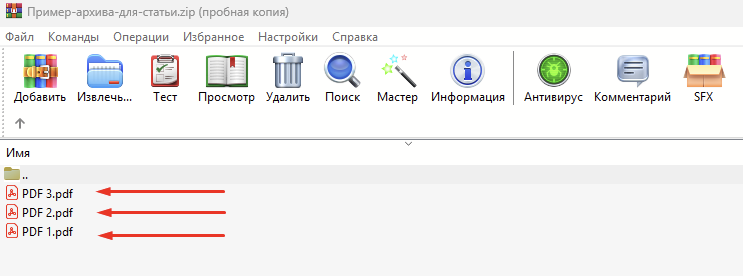
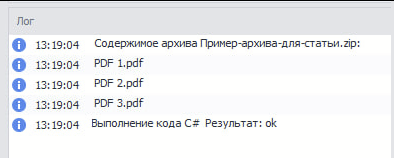
В ЛОГе видим название всех файлов внутри архива, а это значит, что мы движемся в верном направлении:
⬇
Что такое PDF-файл на самом деле?Прежде, чем перейти к следующему шагу - нужно немного разобраться с тем, что из себя представляют PDF-файлы. PDF файл - это не просто набор текста и гиперссылок на белом фоне. Это структурированный документ из текста, методанных, страниц, шрифтов и т.п.
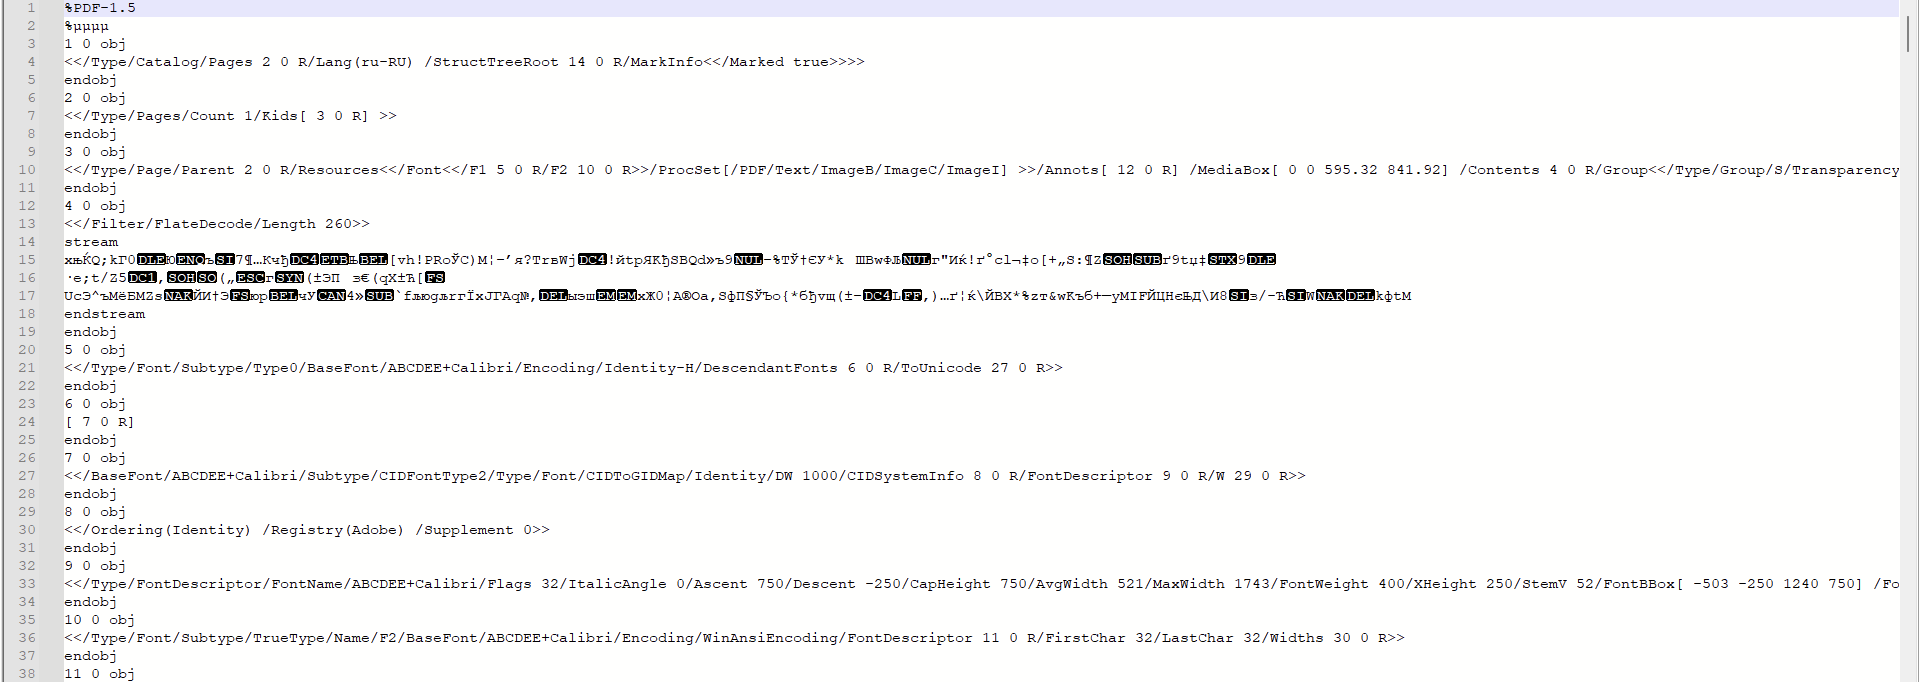
Так видим его мы, но на нижнем уровне - это бинарный файл, т.е. структурированный набор байтов от 0 до 255, которые pdf-интерпритатор (например adobe acrobat) показывает нам в понятном и читаемом виде. Кстати, именно поэтому, если открыть PDF-файл в текстовом редакторе, то мы увидим набор кракозябр.
Текстовый редактор, например Notepad++, банально не понимает бинарную систему файла в формате pdf:
Смотрим на бинарный вид PDF-файлов с помощью c#Теперь мы знаем, что такое PDF файлы, поэтому следующим шагом мы конвертируем найденные PDF-файлы в бинарный вид. Для этого модернизируем предыдущий код и посмотрим как PDF файлы выглядят в бинарном виде:
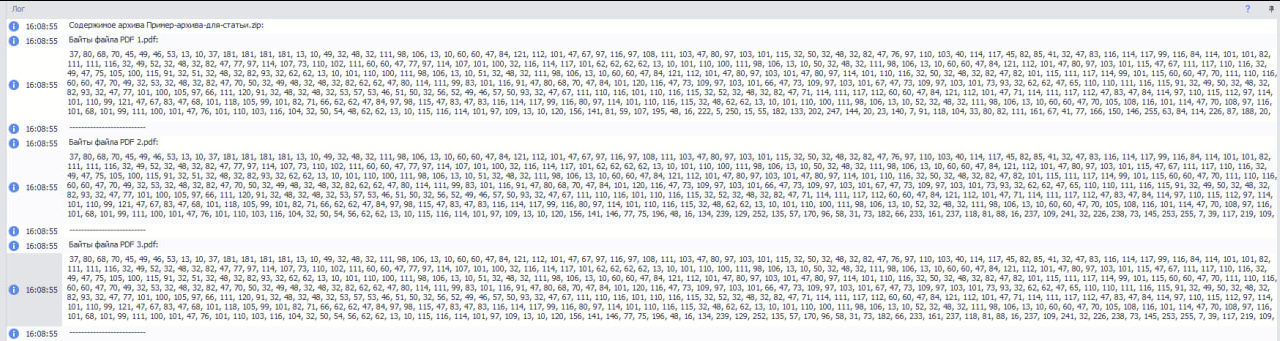
В результате в ЛОГе мы увидим 3 PDF-файла в бинарном виде:
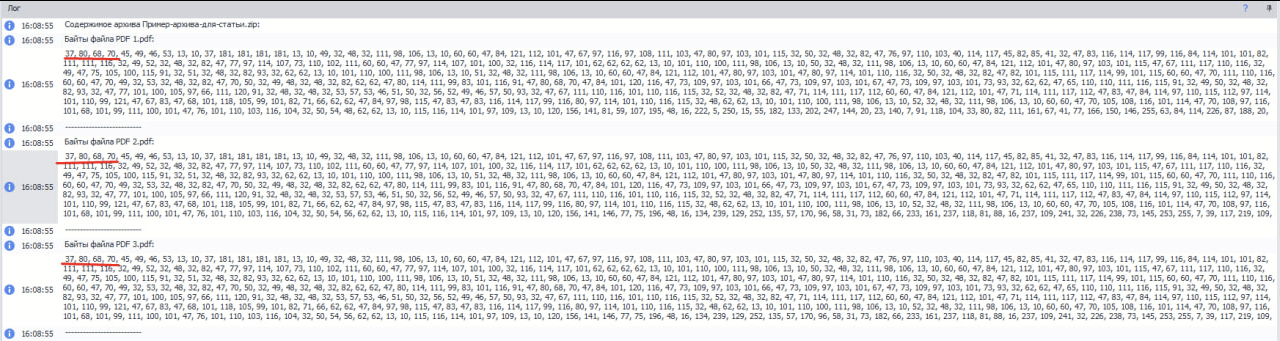
Обратите внимание на первые байты во всех файлах: 37 80 68 70
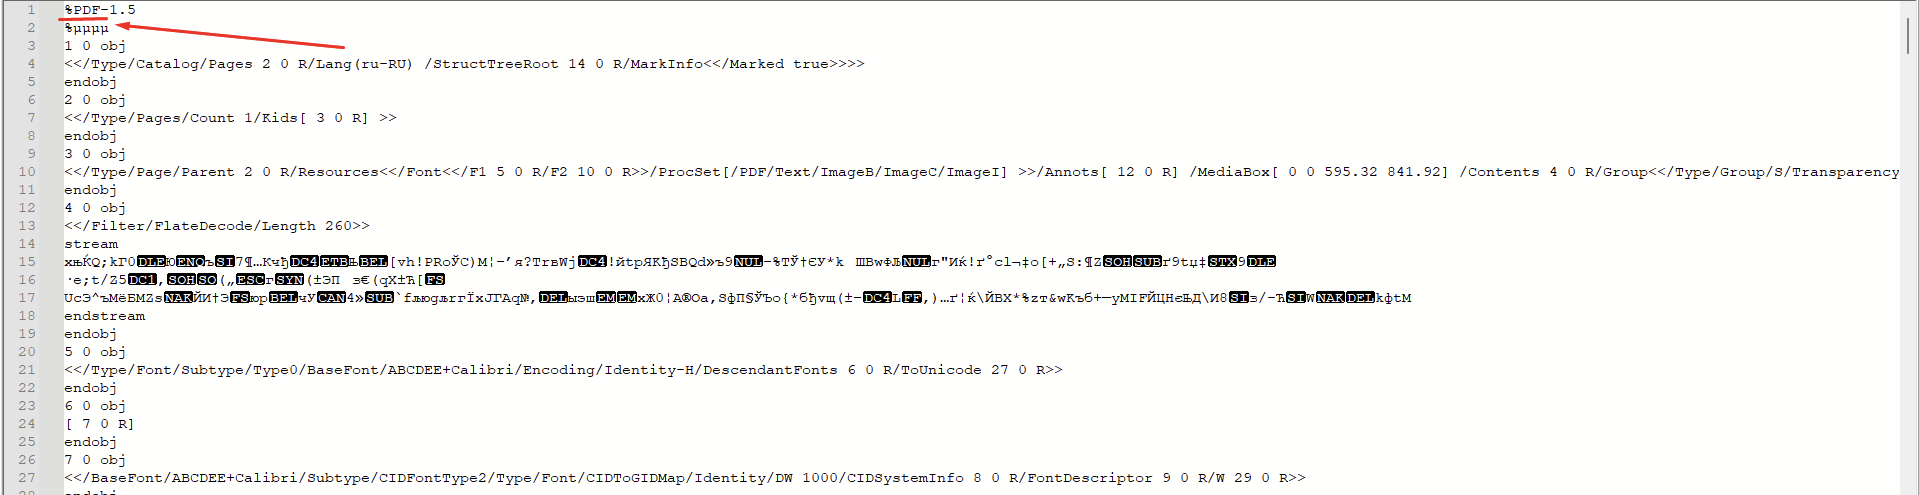
Если перевести эти десятичные байты в символы, то получиться %PDF - именно так начинается любой PDF-файл (это специальный маркер для PDF-ридера) и именно это в понятном виде мы видим даже среди кракозябр в txt-редакторе:
Библиотека Aspose.Pdf.dll. Что такое ссылка в PDF на самом деле?Как я писал ранее, PDF - это не просто набор текста, а сложная структура из текста, метаданных, страниц, шрифтов и т.п. Одной лишь библиотеки Chilkat не хватит для работы с такой структурой, поэтому воспользуемся специализированной библиотекой Aspose.Pdf.dll
С помощью этой библиотеки мы сможем, например, спарсить текст и ссылки из PDF-файлов для их дальнейшего анализа. Это наша основная задача на эту статью.
Прежде чем перейти к следующему шагу - нам снова необходимо изучить немного теории о структуре PDF.
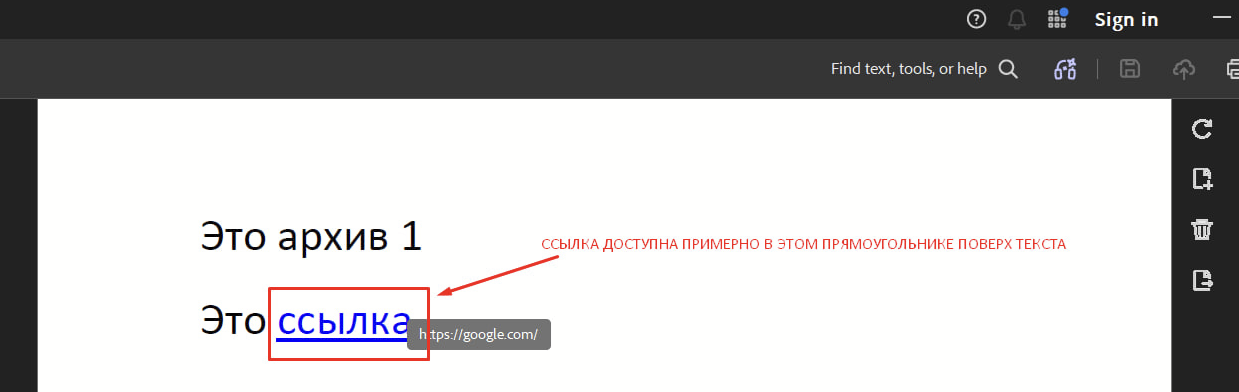
Ссылки в структуре pdf-файлов хранятся как объекты типа Link Annotation (аннотация-ссылка). Но самое интересное, что этот объект представляет собой дополнительный слой поверх текста (или поверх любой другой области) в виде прямоугольника.
Именно поэтому, когда мы наводим мышку на гиперссылку - нам не обязательно попасть прямо по тексту, т.к. область ссылки является прямоугольником, который может выходить за область букв.
Теперь давайте модернизируем наш предыдущий код и получим готовый вариант парсинга текста и ссылок с PDF-файлов из zip-архива.
Это причина и следствие. MemoryStream - это поток для чтения байтов, который расположен в оперативной памяти. Раз мы открыли поток для чтения байтов, то нам его нужно и закрыть, чтобы освободить ресурсы. Конструкция using позволяет закрыть поток автоматически после выполнения кода.
Прямой путь к файлу безусловно удобнее, но дело в том, что наши PDF-файлы находятся в архиве .zip, а это значит, что у них банально нет пути к файлу. Поэтому мы и используем поток MemoryStream.
2) Почему для парсинга ссылок мы перебираем все страницы с помощью цикла for (int pageIndex = 1; pageIndex <= pdf.Pages.Count; pageIndex++){...}, а для парсинга текста мы так не делаем?
Потому что в случае с текстом - Aspose уже умеет перебрать все страницы самостоятельно с помощью функции: pdf.Pages.Accept(absorber);
3) Что происходит в цикле foreach?
В этом цикле мы перебираем анотации на всей странице. Т.к. не каждая аннотация является ссылкой, мы сперва пробуем преобразовать аннотацию к ссылке-анотации LinkAnnotation с помощью строки:
Если такое такое преобразование не получилось, то мы просто заканчиваем эту итерацию цикла и переходим к другой. Это делается с помощью проверки:
Предположим, что найденная анотация является ссылкой. Но какой ссылкой она является? Ссылкой на другую страницу? Сноской на другой абзац? Или же ссылкой на внешний ресурс в интернете?
В этой статье нас интересует только ссылки на внешние ресурсы. Поэтому нам нужно проверить, является ли найденная ссылка "Ссылкой на внешний ресурс в интернете". Если ссылка является ссылкой на внешний ресурс (т.е. GoToURIAction), то сохраняем аннотацию в переменную uriAction.
После этого парсим "голую" ссылку в переменную url:
И если она не пустая, то добавляем ссылку в links.
4) Зачем нужна конструкция try finally?
Задача конструкции try finally в том, чтобы в любом случае выполнить блок finally, независимо от результата в блоке try.
В нашем случае в блоке try находится весь основной код, а в блоке finally находится команда pdf.Dispose(), которая закрывает текущий открытый pdf-файл и освобождает все ресурсы, связанные с ним.
Если во время парсинга pdf-файла возникнет непредвиденная ошибка, то он не останется открытым и ресурсы будут освобождены.
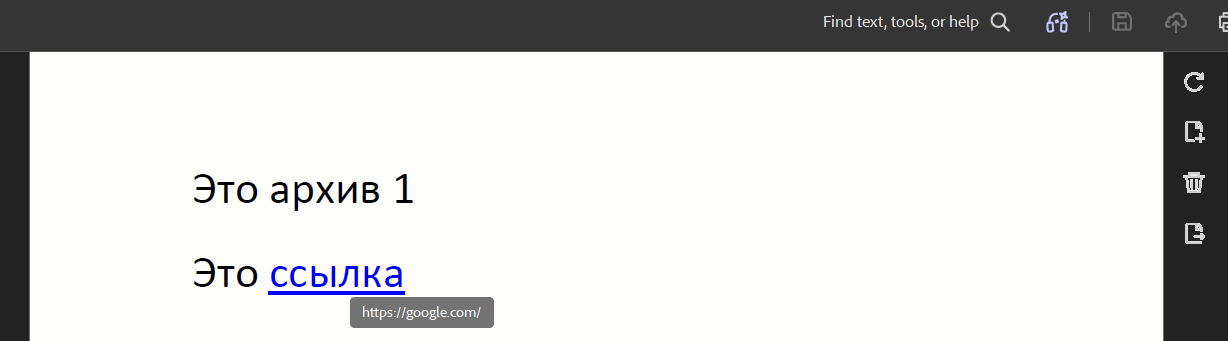
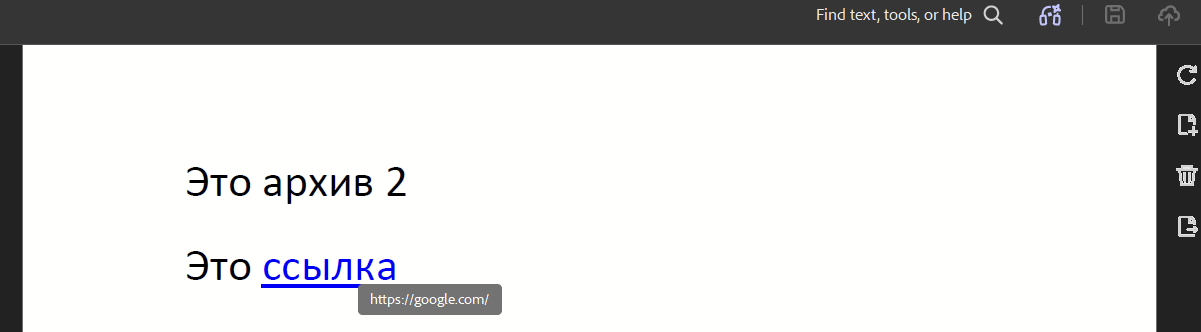
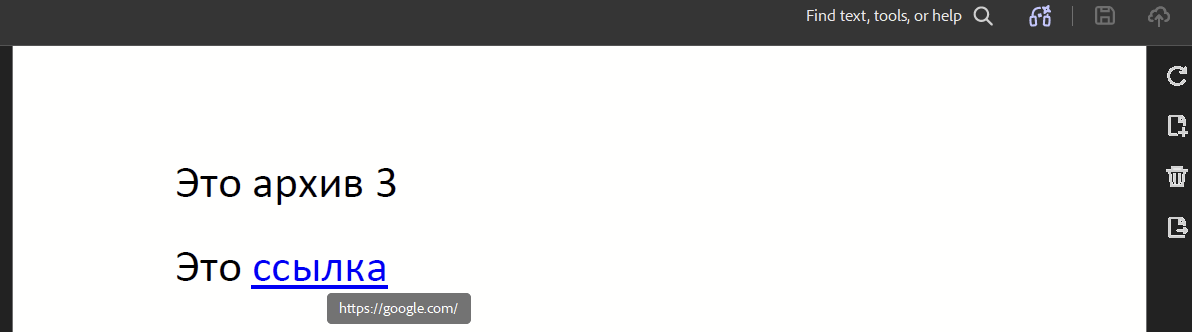
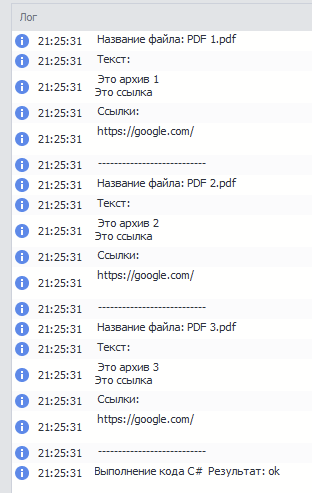 В ЛОГе видим, что текст и ссылки успешно спарсились из PDF-файла внутри архива.
Подводим итогиВ этой статье мы узнали:
1) Как заглянуть внутрь dll-библиотеки для быстрого просмотра доступных классов\методов.
2) Что такое PDF-файл и как он выглядит в бинарном представлении.
3) Библиотеку Chilkat и часть её возможностей.
4) Библиотеку Aspose.Pdf и часть её возможностей.
5) Что из себя представляют ссылки в PDF-файле.
От себя добавлю комментарий о важности изучения деталей. Зачастую детали отличают профи от любителя.
Кто знает, возможно более тонкое изучение структуры PDF-файлов (и любых других форматов файлов) кое-кому помогает намного лучше понимать, как именно спам-фильтры почтовых сервисов смотрят файлы (атачи) в отправляемых письмах
Понравилась статья?
Еще больше статей будет в моём блоге в TG, подпишись:
t.me/brabus_soft_channel
Вступление
В этой статье продолжу цепочку статей по изучению c#. Разберём на практике небольшой пример по применению c# в Zennoposter. Для понимания этой статьи вам достаточно владеть базовыми знаниями по c#.Если базовых навыков пока нет, то можете сперва изучить другие мои статьи:
Начинаем кодить на c# (часть 1). Основы.
Начинаем кодить на с# (часть 2). Что такое ООП? Принципы ООП. Примеры для Zennoposter.
Я занимаюсь email-рассылками и часто сталкиваюсь с задачами, которые выходят за рамки стандартных кубиков Zennoposter, но хорошо решаются с помощью кода. В этот раз столкнулся с задачей: нужно распаковать много архивов с PDF-файлами и спарсить их содержимое, и на основе полученных данных делать уже другие задачи.
Скорее всего, опытные email-траферы понимают, зачем именно иногда нужно заглянуть внутрь PDF-файлов (может быть и не своих?), а в моём случае их ещё сперва нужно доставть из zip-архивов.
С чего начинается решение практически любой задачи в программировании?
С понимая, что такая задача с вероятностью 99.9% уже была кем-то решена, а значит уже есть готовые библиотеки. Библиотека - это набор готового кода, заточенного под определенные задачи.Библиотеку можно нагуглить или обратиться к ИИ. В этот раз мне было немного некогда гуглить и GPT-шить готовые библиотеки, поэтому я пользовался тем, что уже было под рукой. Библиотека Chilkat идёт в комплекте с Zennoposter (по-моему до сих пор идёт в комплекте) и частенько используется email-разработчиками, включая меня, т.к. в этой библиотеке есть полезные методы для работы с почтой.
Например, у себя в проектах с помощью этой библиотеки я отслеживаю попадание писем в инбокс или спам на контрольных почтах.
Заглядываем внутрь библиотеки с помощью c#
Я примерно помнил, что в этой библиотеке были классы для работы с zip-архивами, но давайте представим, что мы точно этого не знаем. Убедимся в этом с помощью короткого кода:
C#:
System.Reflection.Assembly assembly = System.Reflection.Assembly.LoadFrom(@"тут путь до вашей папки с Zennoposter\Progs\ExternalAssemblies\ChilkatDotNet45-64.dll");

foreach (Type type in assembly.GetTypes())
{
    if (type.IsClass)
        project.SendInfoToLog($"Нашли класс: {type.FullName}");
}
Данный код заглядывает внутрь библиотеки и построчно показывает её содержимое.
Сделаю пару комментарием для лучшего понимания. В этом коде:
1) Assembly - это класс внутри пространства имён System.Reflection, который позволяет работать с .NET-сборками в формате .dll (библиотеками).
Отсюда получаем конструкцию System.Reflection.Assembly
2) LoadFrom - метод, который загружает .NET-сборку из файла .dll. После этого мы можешь посмотреть классы и методы внутри библиотеки.
Отсюда получаем конструкцию System.Reflection.Assembly.LoadFrom(@"тут_путь_до_библиотеки");
3) foreach - цикл с удобной конструкцией для перебора всего содержимого (элементов\объектов) в массивах и коллекциях.
Это аналог цикла for, но не нужно указывать сколько итераций (шагов) нужно сделать.
4) У класса Assembly есть метод GetTypes(), с помощью которого можно получить коллекцию с типом данных Type.
Отсюда получаем конструкцию Type type in assembly.GetTypes().
5) Отсюда получаем конструкцию foreach (Type type in assembly.GetTypes())
Простыми словами: "Поочередно возьми все типы из библиотеки и записывай тип в переменную type"
6) И если тип является классом:
if (type.IsClass)
7) То выведи его название в ЛОГ:
project.SendInfoToLog($"Нашли класс: {type.FullName}");
Простым языком, мы сделали следующее:
Подгрузили библиотеку Chilkat.
Распаковали её.
Поочередно вывели в ЛОГ название всех классов.
И бинго! В ЛОГе мы видим что-то связанное с zip-архивами Chilkat.Zip:
Заглядываем внутрь zip-архива с помощью c#
Для этого в кубике c# создадим объект класса Chilkat.Zip и посмотрим через знак точки, какие методы нам доступны. Банальным просматриваем я натыкаюсь на метод zip.OpenZip, который еще и на вход принимает путь к архиву zipPath.
На всякий случай я убедился, что это то, что нам нужно. Благо, что у разработчиков баблиотеки есть очень подробные мануалы:
https://www.chilkatsoft.com/refdoc/xChilkatZipRef.html#OpenZip
Давайте теперь протестируем найденный метод zip.OpenZip и попробуем с помощью него вывести в ЛОГ содержимое архива. Для этого выполним короткий код:
C#:
string archivePath = @"тут_путь_до_архива";

Chilkat.Zip zip = new Chilkat.Zip();

if (!zip.OpenZip(archivePath))
    throw new Exception($"Не удалось открыть ZIP: {zip.LastErrorText}");

project.SendInfoToLog($"Содержимое архива {Path.GetFileName(archivePath)}:", false);

for (int i = 0; i < zip.NumEntries; i++)
{
    Chilkat.ZipEntry entry = zip.GetEntryByIndex(i);

    project.SendInfoToLog(entry.FileName);
}
В ЛОГе видим название всех файлов внутри архива, а это значит, что мы движемся в верном направлении:
⬇
Что такое PDF-файл на самом деле?
Так видим его мы, но на нижнем уровне - это бинарный файл, т.е. структурированный набор байтов от 0 до 255, которые pdf-интерпритатор (например adobe acrobat) показывает нам в понятном и читаемом виде. Кстати, именно поэтому, если открыть PDF-файл в текстовом редакторе, то мы увидим набор кракозябр.
Текстовый редактор, например Notepad++, банально не понимает бинарную систему файла в формате pdf:
Смотрим на бинарный вид PDF-файлов с помощью c#
C#:
string archivePath = @"тут путь до zip архива";

Chilkat.Zip zip = new Chilkat.Zip();

if (!zip.OpenZip(archivePath))
    throw new Exception($"Не удалось открыть ZIP: {zip.LastErrorText}");

project.SendInfoToLog($"Содержимое архива {Path.GetFileName(archivePath)}:");

for (int i = 0; i < zip.NumEntries; i++)
{
    Chilkat.ZipEntry entry = zip.GetEntryByIndex(i);

    //project.SendInfoToLog(entry.FileName)

    //Создаём контейнер для бинарных данных PDF
    Chilkat.BinData pdfBin = new Chilkat.BinData();

    //Извлекаем PDF из архива в BinData и сразу проверяем, удалось ли извлечение
    if(!entry.UnzipToBd(pdfBin))
        throw new Exception($"Не удалось извлечь PDF {entry.FileName}: {entry.LastErrorText}");

    //Получаем PDF в виде массива байтов
    byte[] pdfByte = pdfBin.GetBinary();

    project.SendInfoToLog($"Байты файла {entry.FileName}:");

    //Выводим байты PDF в лог
    project.SendInfoToLog(string.Join(", ", pdfByte));

    project.SendInfoToLog("--------------------------");
}
В результате в ЛОГе мы увидим 3 PDF-файла в бинарном виде:
Обратите внимание на первые байты во всех файлах: 37 80 68 70
Если перевести эти десятичные байты в символы, то получиться %PDF - именно так начинается любой PDF-файл (это специальный маркер для PDF-ридера) и именно это в понятном виде мы видим даже среди кракозябр в txt-редакторе:
Библиотека Aspose.Pdf.dll. Что такое ссылка в PDF на самом деле?
С помощью этой библиотеки мы сможем, например, спарсить текст и ссылки из PDF-файлов для их дальнейшего анализа. Это наша основная задача на эту статью.
Прежде чем перейти к следующему шагу - нам снова необходимо изучить немного теории о структуре PDF.
Ссылки в структуре pdf-файлов хранятся как объекты типа Link Annotation (аннотация-ссылка). Но самое интересное, что этот объект представляет собой дополнительный слой поверх текста (или поверх любой другой области) в виде прямоугольника.
Именно поэтому, когда мы наводим мышку на гиперссылку - нам не обязательно попасть прямо по тексту, т.к. область ссылки является прямоугольником, который может выходить за область букв.
Теперь давайте модернизируем наш предыдущий код и получим готовый вариант парсинга текста и ссылок с PDF-файлов из zip-архива.
C#:
string archivePath = @"тут путь до zip архива";

Chilkat.Zip zip = new Chilkat.Zip();

if(!zip.OpenZip(archivePath))
    throw new Exception($"Не удалось открыть ZIP: {zip.LastErrorText}");

for(int i = 0; i < zip.NumEntries; i++)
{
    Chilkat.ZipEntry entry = zip.GetEntryByIndex(i);

    string pdfName = entry.FileName;

    // Парсим PDF в BinData
    Chilkat.BinData pdfBin = new Chilkat.BinData();

    if(!entry.UnzipToBd(pdfBin))
        throw new Exception($"Не удалось открыть PDF: {pdfName} | Ошибка: {entry.LastErrorText}");

    // Получаем PDF как byte[]
    byte[] pdfByte = pdfBin.GetBinary();

    // Открываем PDF через Aspose
    using(System.IO.MemoryStream pdfStream = new System.IO.MemoryStream(pdfByte))
    {
        Aspose.Pdf.Document pdf = new Aspose.Pdf.Document(pdfStream);

        try
        {
            //Получаем текст
            TextAbsorber absorber = new TextAbsorber();

            pdf.Pages.Accept(absorber);

            string pdfText = absorber.Text;

            //Получаем гиперссылки
            System.Text.StringBuilder links = new System.Text.StringBuilder();

            for(int pageIndex = 1; pageIndex <= pdf.Pages.Count; pageIndex++)
            {
                Aspose.Pdf.Page page = pdf.Pages[pageIndex];

                foreach(Annotation annotation in page.Annotations)
                {
                    LinkAnnotation link = annotation as LinkAnnotation;

                    if(link == null)
                        continue;

                    if(link.Action is GoToURIAction uriAction)
                    {
                        string url = uriAction.URI;

                        if(!string.IsNullOrEmpty(url))
                            links.AppendLine(url);
                    }
                }
            }

            //Выводим результат в ЛОГ
            project.SendInfoToLog($"Название файла: {pdfName}");

            project.SendInfoToLog("Текст:");
            project.SendInfoToLog(pdfText);

            project.SendInfoToLog("Ссылки:");
            project.SendInfoToLog(links.ToString());

            project.SendInfoToLog("---------------------------");
        }
        finally
        {
            pdf.Dispose();
        }
    }
}
Подробнее остановлюсь на тех моментах, которые могут вызвать вопросы.
1) Зачем тут using и для чего мы создаём поток MemoryStream?
C#:
using (System.IO.MemoryStream pdfStream = new System.IO.MemoryStream(pdfByte))
{

}
Это причина и следствие. MemoryStream - это поток для чтения байтов, который расположен в оперативной памяти. Раз мы открыли поток для чтения байтов, то нам его нужно и закрыть, чтобы освободить ресурсы. Конструкция using позволяет закрыть поток автоматически после выполнения кода.
C#:
//Библиотека Aspose позволяет нам обратиться к PDF-файлу либо через поток:
Aspose.Pdf.Document pdf = new Aspose.Pdf.Document(pdfStream);

//Либо через прямой путь к файлу:
Aspose.Pdf.Document pdf = new Aspose.Pdf.Document(string fileName);
Прямой путь к файлу безусловно удобнее, но дело в том, что наши PDF-файлы находятся в архиве .zip, а это значит, что у них банально нет пути к файлу. Поэтому мы и используем поток MemoryStream.
2) Почему для парсинга ссылок мы перебираем все страницы с помощью цикла for (int pageIndex = 1; pageIndex <= pdf.Pages.Count; pageIndex++){...}, а для парсинга текста мы так не делаем?
Потому что в случае с текстом - Aspose уже умеет перебрать все страницы самостоятельно с помощью функции: pdf.Pages.Accept(absorber);
3) Что происходит в цикле foreach?
C#:
foreach (Annotation annotation in page.Annotations)
{
    LinkAnnotation link = annotation as LinkAnnotation;

    if (link == null)
        continue;

    if (link.Action is GoToURIAction uriAction)
    {
        string url = uriAction.URI;

        if (!string.IsNullOrEmpty(url))
            links.AppendLine(url);
    }
}
В этом цикле мы перебираем анотации на всей странице. Т.к. не каждая аннотация является ссылкой, мы сперва пробуем преобразовать аннотацию к ссылке-анотации LinkAnnotation с помощью строки:
C#:
LinkAnnotation link = annotation as LinkAnnotation;Если такое такое преобразование не получилось, то мы просто заканчиваем эту итерацию цикла и переходим к другой. Это делается с помощью проверки:
C#:
if (link == null)
    continue;
Предположим, что найденная анотация является ссылкой. Но какой ссылкой она является? Ссылкой на другую страницу? Сноской на другой абзац? Или же ссылкой на внешний ресурс в интернете?
В этой статье нас интересует только ссылки на внешние ресурсы. Поэтому нам нужно проверить, является ли найденная ссылка "Ссылкой на внешний ресурс в интернете". Если ссылка является ссылкой на внешний ресурс (т.е. GoToURIAction), то сохраняем аннотацию в переменную uriAction.
C#:
if (link.Action is GoToURIAction uriAction)
{
 //тут тело цикла
}
После этого парсим "голую" ссылку в переменную url:
C#:
string url = uriAction.URI;И если она не пустая, то добавляем ссылку в links.
C#:
if(!string.IsNullOrEmpty(url))
    links.AppendLine(url);
4) Зачем нужна конструкция try finally?
C#:
try
{
    //тут весь основной код
}
finally
{
    pdf.Dispose();
}
Задача конструкции try finally в том, чтобы в любом случае выполнить блок finally, независимо от результата в блоке try.
В нашем случае в блоке try находится весь основной код, а в блоке finally находится команда pdf.Dispose(), которая закрывает текущий открытый pdf-файл и освобождает все ресурсы, связанные с ним.
Если во время парсинга pdf-файла возникнет непредвиденная ошибка, то он не останется открытым и ресурсы будут освобождены.
Результат выполнения кода c#
Давайте запустим код и проверим результат выполнения в ЛОГе:Подводим итоги
1) Как заглянуть внутрь dll-библиотеки для быстрого просмотра доступных классов\методов.
2) Что такое PDF-файл и как он выглядит в бинарном представлении.
3) Библиотеку Chilkat и часть её возможностей.
4) Библиотеку Aspose.Pdf и часть её возможностей.
5) Что из себя представляют ссылки в PDF-файле.
От себя добавлю комментарий о важности изучения деталей. Зачастую детали отличают профи от любителя.
Кто знает, возможно более тонкое изучение структуры PDF-файлов (и любых других форматов файлов) кое-кому помогает намного лучше понимать, как именно спам-фильтры почтовых сервисов смотрят файлы (атачи) в отправляемых письмах
Понравилась статья?
Еще больше статей будет в моём блоге в TG, подпишись:
t.me/brabus_soft_channel