
- Регистрация
- 24.12.2024
- Сообщения
- 72
- Реакции
- 170
- Баллы
- 33
Модульный конвейер автогенерации
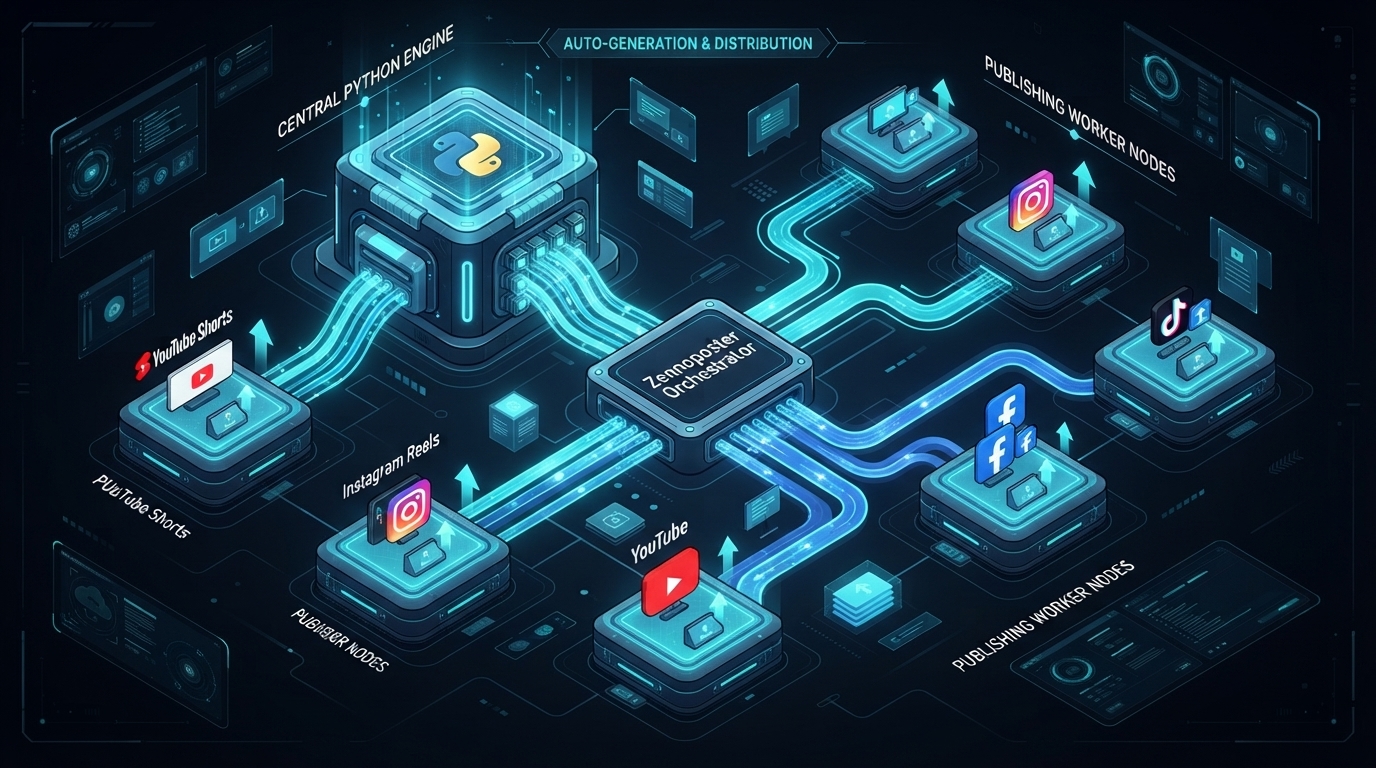
и мультиплатформенной дистрибуции контента (Shorts, Reels, TikTok) на базе ZennoPoster
Полный разбор рабочей системы: генератор контента, оркестратор загрузки и пять «холостых» проектов-издателей, работающих параллельно
Система, которая каждый день сама придумывает тему, пишет сценарий, озвучивает, монтирует и разносит готовый ролик по площадкам — а вы просто иногда заглядываете, как у неё дела
и мультиплатформенной дистрибуции контента (Shorts, Reels, TikTok) на базе ZennoPoster
Полный разбор рабочей системы: генератор контента, оркестратор загрузки и пять «холостых» проектов-издателей, работающих параллельно
Система, которая каждый день сама придумывает тему, пишет сценарий, озвучивает, монтирует и разносит готовый ролик по площадкам — а вы просто иногда заглядываете, как у неё дела
1. Философия модульности: почему монолит рано или поздно ломается
У почти любого SMM-автоматизатора есть свой «монолит первой версии» — один длинный скрипт, где генерация текста, сборка видео и публикация в Instagram склеены в единую цепочку блоков. Работает он ровно до того дня, когда Instagram меняет разметку кнопки загрузки, а вместе с ней падает вся конструкция целиком — включая ещё не отправленную публикацию в YouTube, которая физически никак не связана со сбоем в Instagram, но стоит в той же очереди действий.Монолит уязвим сразу в трёх местах одновременно:
- Точка отказа одна на всех. Изменение вёрстки, капча или бан аккаунта на одной площадке останавливает генерацию контента для всех остальных — хотя логически это два независимых процесса.
- Поддержка становится комбинаторной. Любое изменение в логике сборки видео требует перепроверки всего скрипта целиком, потому что непонятно, что от чего зависит.
- Масштабирование требует копирования, а не переиспользования. Чтобы завести вторую нишу («цитаты» вместо «финансов»), приходится клонировать весь монолит и вручную вычищать из копии всё лишнее.
| Модуль | Что делает | Технология |
|---|---|---|
| 1–2. Генерация контента | Находит тему, пишет сценарий, озвучивает, монтирует горизонтальное и вертикальное видео, готовит обложку и метаданные | Python-конвейер trend_pipeline |
| 3. Оркестратор загрузки | Регулирует, сколько роликов сгенерировать за сессию, забирает готовые файлы и раскладывает их по очередям пяти площадок | Отдельный проект ZennoPoster (orcestrator) |
| 4. Публикация | Пять независимых проектов ZennoPoster, каждый — на свою площадку, работают в режиме ожидания | youtube.zp / TikTok.zp / instagram.zp / facebook.zp / youtube_short.zp |
2. Главная идея кейса: оркестратор и издатели работают параллельно, а не по очереди
Это шаблон, а не готовый бот
Ключевая архитектурная деталь, вокруг которой построен весь кейс, легко упускается при первом взгляде на проект: пять публикующих проектов ZennoPoster запускаются и работают полностью независимо от оркестратора. Их запускают вручную или по расписанию — и они остаются работать в режиме ожидания («холостой ход»): бесконечно опрашивают свою общую папку раз в 60 секунд, ищут файл-триггер to_work, и если его нет — просто ждут дальше, не потребляя заметных ресурсов. Оркестратор — это ШЕСТОЙ, отдельный проект ZennoPoster, который запускается параллельно (можно на том же ПК вторым процессом ZennoPoster, можно на другой машине) и занимается только одним: решает, сколько контента сгенерировать за сессию, вызывает Python-конвейер, и раскладывает готовые файлы по очередям — но сам никогда не открывает браузер и не публикует ничего напрямую.
Из этого следует практическая инструкция по запуску всей системы, которая стоит того, чтобы держать её перед глазами:
- Открыть в ZennoPoster (или запустить по расписанию) каждый из пяти публикующих проектов (youtube, youtube_short, TikTok, instagram, facebook) — они уходят в режим ожидания и будут работать сколь угодно долго, ничего не делая, пока не появится сигнал.
- Отдельно, в любой момент, запустить проект orcestrator — он сам решит, сколько роликов сгенерировать (см. переменную {-Variable.kvo_video_in_day-} в разделе 5.3), вызовет генерацию и разложит результат по очередям.
- Как только оркестратор кладёт файлы в очередь конкретной площадки, соответствующий публикующий проект (который всё это время просто ждал) подхватывает сигнал и публикует — оркестратору для этого не нужно ничего дополнительно запускать или дожидаться.
- Оркестратор можно останавливать, перезапускать или вообще не запускать несколько дней подряд — публикующие проекты от этого не пострадают, они просто продолжат ждать; и наоборот, публикующие проекты можно перезапустить в любой момент, не прерывая работу оркестратора.
Это ровно тот же файловый протокол «сигнал → работа → отчёт», который использует связка ZennoPoster + мобильное приложение в других кейсах этой серии — только здесь по обе стороны файловой шины стоят не Android-макросы, а такие же проекты ZennoPoster. Порядок запуска (сначала издатели, потом оркестратор, или наоборот) не имеет значения именно потому, что обе стороны общаются только через файлы на диске, а не напрямую друг с другом.
3. Практические сценарии применения
3.1. Автономные сетки пабликов под узкие ниши
Модуль генерации не привязан к конкретной теме — тема добывается либо автоматически из публичных API трендов (Hacker News, Reddit, Wikipedia Trending — все три включены и бесплатны по умолчанию), либо из вашей папки с материалами. Один и тот же конвейер обслуживает сколько угодно параллельных ниш: достаточно завести под каждую нишу свой config/settings.yaml с собственными niche/brand_name и набором площадок — и получить независимую фабрику контента для «финансов», «цитат», «новостей», «фактов» или «выдержек из подкастов», не копируя ни строчки кода.
3.2. Ежедневный автопостинг без участия человека
Конвейер спроектирован так, чтобы работать по расписанию совсем без присмотра:- Журнал пройденных тем (data/topics_journal.json) гарантирует, что тема, на которую уже был сделан ролик, никогда не будет предложена повторно — даже спустя недели между запусками; глубина «забывания» настраивается через trends.journal.retention_days.
- Флаг --count N (или run.count в конфиге) производит N роликов за один прогон, и каждый гарантированно получает свою, ещё не использованную тему.
- Если все найденные темы у включённых источников трендов закончились, конвейер сам расширяет охват запроса (trends.exhaustion_retry) и пробует снова — вместо того чтобы просто упасть с ошибкой посреди ночи.
- Сбой у одного внешнего провайдера (AI-картинки, TTS) на ОДНОЙ сцене не роняет весь прогон — сцена подменяется плейсхолдером с предупреждением в консоли, остальные обрабатываются как обычно.
4. Модуль генерации контента: что такое trend_pipeline
Прежде чем разбирать оркестратор ZennoPoster (раздел 5), стоит подробно остановиться на том, что именно он вызывает командой generate_videos (блок 2) — Python-конвейер trend_pipeline. Ниже — не пересказ по скриншотам, а прямое изложение приложенной документации проекта (README.md, PLAN.md, requirements.txt).
4.1. Философия: одна тема — не хардкод, а результат шага 00
Конвейер делает контент на ЛЮБУЮ тему, а не под конкретную нишу. Тема появляется одним из двух способов (config -> input.mode):
1. `trends_api` (по умолчанию) — тема сама находится через публичные API трендов. Конвейер не «знает» тему заранее: весь текст промптов в папке prompts/ написан универсально, в терминах «тема», «тренд», «факты» — без предположений об области.2. `project_folder` — тема и материалы приходят из подготовленной человеком папки. Конвейер и здесь не хардкодит нишу: категории фото — это просто имена подпапок (img/category_a/*.jpg), какими бы они ни были.
Оба режима производят одинаковую структуру data/<video_id>_facts.json (source_dir / facts / image_categories / pdf_documents), поэтому все шаги после 00 не знают и не должны знать, какой режим был использован.
4.2. Профили как единый паттерн для любой внешней зависимости
LLM, TTS и генерация картинок решены одним и тем же паттерном: PROVIDERS (что вообще есть, какой ключ нужен) + PROFILES (готовая связка провайдер+модель под одну строку в конфиге) + resolve_*_config() (понятная ошибка, если ключа нет или профиль не существует) — специально одинаково в трёх местах (llm_providers.py, tts_providers.py, image_providers.py), чтобы добавление четвёртого вида внешней зависимости (например, AI-видео вместо статичных кадров) шло по тому же шаблону, а не изобретало свой.| Переключатель | Профиль по умолчанию | Требует ключ? | Реестр |
|---|---|---|---|
| LLM (сценарий/метаданные/обложка) | gemini_fast (Google) | Да, но щедрый бесплатный тариф | llm_providers.py |
| TTS (озвучка) | free_edge (Microsoft Edge TTS) | Нет | tts_providers.py |
| Генерация картинок под сцены | free_pollinations (Pollinations.ai) | Нет | image_providers.py |
Другие доступные профили LLM: openai_cheap, openai_best, claude_balanced, claude_top, groq_fast, deepseek_cheap, openrouter_claude, openrouter_gemini, local_free (Ollama, вообще без ключа). Для TTS в продакшене — elevenlabs_premium или openai_premium. Для картинок — openai_images, stability_sdxl, flux_replicate, либо disabled (сцены получают брендовый плейсхолдер вместо картинки). Все ключи — в одном файле api_keys.env (копия api_keys.env.example); каждый профиль запрашивает только свой ключ по имени, если он реально понадобился.
Почему AI-генерация картинок реализована по-настоящему, а не оставлена стабом:
В режиме trends_api фото физически неоткуда взять — значит генерация изображений не может быть «точкой расширения на будущее», она обязана работать из коробки. Дефолт — Pollinations.ai: бесплатно, без ключа и без регистрации, чтобы весь конвейер целиком проверялся бесплатно от идеи до готового видео. Платные провайдеры — для продакшен-качества, когда бесплатного достаточно для проверки, но не для финального результата.
4.3. Шаги конвейера (00–09)
Полный список и порядок — STEP_REGISTRY в scripts/orchestrator.py; каждый шаг включается/выключается отдельно в конфиге и запускается вручную (python scripts/01_...py --help):| Шаг | Что делает |
|---|---|
| 00_ingest_assets | тема ролика: тренд из API либо разбор папки проекта |
| 01_generate_script | сценарий (LLM либо фикстура) |
| 02_generate_voiceover | текст под TTS: числа прописью, паузы (LLM либо фикстура) |
| 03_generate_tts_audio | озвучка |
| 04_generate_visual_prompts | подбор фото / промпт под AI-картинку на сцену |
| 05_prepare_visual_assets | AI-генерация картинок + подготовка кадров (Ken Burns) |
| 06_assemble_video | сборка видео (ffmpeg) |
| 07_generate_shorts | вертикальная версия под Shorts/Reels/TikTok |
| 08_generate_thumbnail | обложка, 3 варианта на A/B (LLM-концепция + Pillow) |
| 09_generate_metadata | заголовки/описания/теги под площадки (LLM либо фикстура) |
Разово переопределить набор шагов без правки конфига:
python scripts/orchestrator.py --only 08_generate_thumbnail,09_generate_metadata
python scripts/orchestrator.py --skip 07_generate_shorts
python scripts/orchestrator.py --list-steps
4.4. Проверка совсем без сети и без ключей
Фикстуры (fixtures/sample_trend/*.json) подменяют ответ LLM только для шагов 01/02/04/08/09 — единственных мест, где реально тратятся деньги/токены. Шаг 00 (подбор темы) и шаг 05 (реальная отрисовка картинок) всегда выполняются по-настоящему — это бесплатные публичные API без ключей, но требующие интернета; подменять их фикстурой не нужно, они и так бесплатны.
# в config/settings.yaml поставьте:
# paths.fixtures_dir: "fixtures/sample_trend"
python scripts/orchestrator.py --video-id sample_trend
4.5. Быстрый старт и структура репозитория
pip install -r requirements.txt --break-system-packagessudo apt install ffmpeg # если ещё не стоит
cp api_keys.env.example api_keys.env
# впишите GOOGLE_API_KEY= — у Google щедрый бесплатный тариф на gemini-2.5-flash,
# это ЕДИНСТВЕННЫЙ ключ, без которого конвейер не запустится по умолчанию
python scripts/orchestrator.py
Важно: публикации на площадки в самом конвейере нет. Он делает контент (шаги 00–09), готовые файлы складывает в output/, дальше их забирает и разносит по площадкам оркестратор ZennoPoster — раздел 5.
config/settings.yaml — единая точка настройки
api_keys.env.example — шаблон ключей
scripts/
orchestrator.py — последовательный запуск шагов 00-09
00_ingest_assets.py .. 09_generate_metadata.py
common/
llm_providers.py, tts_providers.py, image_providers.py — реестры провайдеров
trends_providers.py — публичные API трендов
llm_client.py — единый call_llm() поверх реестра
paths.py — разрешение путей/активного проекта
prompts/ — все LLM-промпты, редактируются без правки кода
fixtures/sample_trend/ — готовый набор JSON для офлайн-теста без LLM
projects_input/ — (project_folder) сюда кладёте папки с материалами
output/ — готовые видео/shorts/обложки/метаданные
data/ — промежуточные JSON конвейера, включая topics_journal.json
clean_project.pyw в trend_pipeline — не тот же файл, что в статье про публикацию:
У самого конвейера генерации есть собственный trend_pipeline\clean_project.pyw (именно его вызывает блок 1 оркестратора, раздел 5.1) — он архивирует папки output/ и projects_input/ в backup/<папка>/<дата>/<расширение>/ перед новой партией генерации. Это ДРУГОЙ скрипт, чем clean_project.pyw, который стоит в каждой из пяти папок публикации («facebook», «instagram» и т.д.) и чистит уже опубликованные video//text//thumbnails/ на стороне издателя — тот разобран в другой статье этой серии. Имя одно, назначение и содержимое — разные: у каждого своя зона ответственности.
5. Оркестратор публикации — разбор по блокам
Проект orcestrator состоит из одиннадцати пронумерованных блоков (нумерация не всегда идёт строго по порядку выполнения — например, блоки YouTube-основной и YouTube-Shorts оба помечены цифрой «7», просто как два соседних под-шага одной группы). Ниже — разбор по фактическому содержимому скриншотов.
5.1. Блок 1 — Обнуление переменной с очисткой директории от старого
Блок 1: сброс счётчика sch, вызов clean_project.pyw и точка входа в цикл генерации
Дальше сценарий сразу уходит в «Начало создания контента» — начало цикла: блок 2.
5.2. Блок 2 — Генерация видео со всем причитаемым
и Блок 3 — Получение готовых файлов
Блоки 2–3: вызов generate_videos (Python-конвейер) и последовательное сканирование очередей output_video / output_shorts / output_metadata
Блок 2 — один внешний вызов, `generate_videos`: это и есть точка, где ZennoPoster обращается к Python-конвейеру trend_pipeline (раздел 4), запуская генерацию очередной партии контента. При сбое — явный алерт «Ошибка генерации видео, проверьте: ...», а не тихое зависание.
Блок 3 повторяет тот же паттерн сканирования очереди, что уже встречался в других кейсах серии: «Удалить строки X» + «Получить список файлов» + повторное «Удалить строки X» + «Получить строку X» — последовательно для output_video, output_shorts, output_metadata (и output_thumbnails, за кадром справа) — конвейер выкладывает готовые файлы в эти папки, а оркестратор построчно вычитывает и вычищает обработанные записи, чтобы не отправить один и тот же ролик дважды.
5.3. Блок 4 — metadata по переменным
и Блок 5 — ожидание конца предыдущей загрузки
Блоки 4–5: разбор metadata через реальный C#-сниппет, счётчик sch++1, порог kvo_video_in_day и параллельное ожидание готовности всех пяти площадок
Блок 4 начинается с условия `{sch}==0`: судя по месту в цепочке, это защита самого первого прохода цикла — на первой итерации ждать «предыдущую загрузку» ещё нечего, поэтому этот случай, похоже, обрабатывается отдельной, короткой веткой в обход основной, тогда как на всех последующих проходах ({sch} уже не 0) выполняется основная зелёная ветка: читается файл `metadata`, затем единственный кастомный C#-код проекта («извлечения текстовых полей metadata из Variables ["input_json"]») раскладывает JSON по переменным под каждую площадку — это в точности тот же сниппет, что уже встречался в статье про мобильную автоматизацию (полный текст — раздел 6.1), только здесь он используется на стороне ZennoPoster-издателей, а не Android-приложения. Следом — «sch ++ 1», инкремент счётчика.
Ниже — единственное условие остановки во всём проекте: {sch}>= {kvo_video_in_day}. Переменная kvo_video_in_day (судя по названию — «количество видео в день») задаёт дневную квоту публикаций и определяет, сколько роликов оркестратор выпустит за сессию. Пока счётчик sch её не достиг, цикл продолжается; при достижении — алерт «Ступень в '{-Variable.kvo_video_in_day-}' достигнута, пайплайн…» и группа файловых операций «finish youtube» / «youtube_short» / «TikTok» / «instagram» / «facebook» вместе с «очистка проекта залива» для каждой площадки (внешние вызовы, судя по иконке — Python или аналогичные скрипты очистки состояния публикующих проектов), после чего сценарий завершается уведомлением «Залив окончен». Пока квота не достигнута, выполнение продолжается к блоку 6 — распределению файлов по очередям, а затем — обратно к «Началу создания контента» для следующей итерации.
Блок 5, «ожидание конца предыдущей загрузки», выполняется параллельно для всех пяти площадок: пять одинаковых троек «проверка на готовность ожиданием файла ready.txt» ↔ «lose.txt» ↔ «Пауза 60 c», а между проверками — «Удалить файл». Это тот же цикл опроса ready.txt/lose.txt, что подробно разобран в статье про мобильную автоматизацию: прежде чем положить новую партию файлов в очередь конкретной площадки, оркестратор убеждается, что предыдущая партия для неё уже дошла до соответствующего издателя и была им обработана — иначе новый to_work мог бы затереть ещё не прочитанный старый.
5.4. Блоки 6–11 — копирование файлов по проектам с командой на старт заливов
Блоки 6–11: пять параллельных очередей (YouTube Main/Short, TikTok, Instagram, Facebook) — запись текстовых полей, копирование обложки и создание файла-триггера to_work
Пять почти одинаковых цепочек, по одной на площадку, объединённых заголовком блока 6. Набор текстовых полей в точности повторяет то, что формирует 09_generate_metadata.py конвейера (раздел 4) и что выше разбирал C#-парсер (блок 4):
| Площадка | Поля очереди | Источник видео |
|---|---|---|
| YouTube (основной) | video, titles, tags, descriptions | Получить строку output_video |
| YouTube Shorts | video, titles, tags, descriptions | Получить строку output_video (та же очередь, что и основной ролик) |
| TikTok | video, tiktok_caption, tags | из очереди TikTok |
| video, instagram_caption, tags | из очереди Instagram | |
| video, facebook_caption | из очереди Facebook (без тегов — площадка их не поддерживает) |
Новая деталь по сравнению с более ранним кейсом про мобильную автоматизацию — у каждой площадки в цепочку добавлен собственный C#-шаг «находит все файлы изображений в исходной папке и копирует их в цел...». Это ровно тот сниппет, что приложен к кейсу отдельно (полный текст — раздел 6.2): он копирует все изображения из trend_pipeline/output/thumbnails в подпапку thumbnails (или covers/caption — по аналогии с именами подпапок конкретной площадки) внутри Публикация по площадкам/<платформа>/, то есть именно на этом шаге обложка, которую сделал конвейер генерации, физически попадает в папку, откуда её потом читает публикующий проект. Только после копирования обложки создаётся сам файл-триггер
to_work — так же, как и в других кейсах серии, последним шагом, когда все данные уже на диске.Пять независимых цепочек — не совпадение, а прямое следствие раздела 2:
Каждая из пяти цепочек блока 6 адресована СВОЕМУ публикующему проекту, который в этот момент уже (или ещё нет) запущен отдельно и ждёт своего to_work в режиме холостого хода. Оркестратору совершенно не важно, запущен ли сейчас конкретный издатель — он просто кладёт файлы в его папку; если издатель не запущен, файлы подождут на диске до следующего его старта.
6. Полный код: два C#-сниппета оркестратора
В самом проекте orcestrator всего два места с кастомным кодом — весь остальной сценарий собран из стандартных блоков ZennoPoster (файловые операции, паузы, условия, внешние вызовы). Оба сниппета — ниже целиком.
6.1. Разбор metadata JSON по площадкам (блок 4)
Тот же сниппет уже разбирался в статье про мобильную автоматизацию — там он стоял на стороне Android-ориентированного оркестратора; здесь он выполняет ровно ту же роль для пяти ZennoPoster-издателей: принимает готовый JSON от 09_generate_metadata.py и раскладывает поля по переменным youtube_title, youtube_description, youtube_tags, instagram_caption, instagram_hashtags, tiktok_caption, tiktok_hashtags, facebook_text — регулярными выражениями, без внешних JSON-библиотек.
C#:
// Получаем JSON из входной переменной проекта
string jsonString = project.Variables["input_json"].Value;

// Проверяем, заполнена ли переменная
if (string.IsNullOrWhiteSpace(jsonString)) {
    project.SendWarningToLog("Сниппет остановлен: входная переменная 'input_json' пуста.", true);
    return "error";
}

try {
    // Вспомогательный метод для извлечения текстовых полей
    string ExtractField(string json, string section, string field) {
        string sectionPattern = $"\"{section}\"\\s*:\\s*\\{{([^\\}}]+)\\}}";
        var sectionMatch = System.Text.RegularExpressions.Regex.Match(json, sectionPattern, System.Text.RegularExpressions.RegexOptions.Singleline);
        if (!sectionMatch.Success) return string.Empty;

        string sectionContent = sectionMatch.Groups[1].Value;
        string fieldPattern = $"\"{field}\"\\s*:\\s*\"([^\"]*)\"";
        var fieldMatch = System.Text.RegularExpressions.Regex.Match(sectionContent, fieldPattern, System.Text.RegularExpressions.RegexOptions.Singleline);

        if (fieldMatch.Success) {
            // Корректно декодируем экранированные символы (например, перевод строк \n)
            return System.Text.RegularExpressions.Regex.Unescape(fieldMatch.Groups[1].Value);
        }
        return string.Empty;
    }

    // Вспомогательный метод для извлечения массивов (теги, хэштеги)
    string ExtractArray(string json, string section, string field, string separator) {
        string sectionPattern = $"\"{section}\"\\s*:\\s*\\{{([^\\}}]+)\\}}";
        var sectionMatch = System.Text.RegularExpressions.Regex.Match(json, sectionPattern, System.Text.RegularExpressions.RegexOptions.Singleline);
        if (!sectionMatch.Success) return string.Empty;

        string sectionContent = sectionMatch.Groups[1].Value;
        string arrayPattern = $"\"{field}\"\\s*:\\s*\\[([^\\]]+)\\]";
        var arrayMatch = System.Text.RegularExpressions.Regex.Match(sectionContent, arrayPattern, System.Text.RegularExpressions.RegexOptions.Singleline);

        if (arrayMatch.Success) {
            string arrayContent = arrayMatch.Groups[1].Value;
            var items = new System.Collections.Generic.List<string>();
            var itemMatches = System.Text.RegularExpressions.Regex.Matches(arrayContent, "\"([^\"]*)\"");
            foreach (System.Text.RegularExpressions.Match m in itemMatches) {
                items.Add(m.Groups[1].Value);
            }
            return string.Join(separator, items);
        }
        return string.Empty;
    }

    // ==========================================
    // 1. YouTube
    // ==========================================
    project.Variables["youtube_title"].Value = ExtractField(jsonString, "youtube", "title");
    project.Variables["youtube_description"].Value = ExtractField(jsonString, "youtube", "description");
    project.Variables["youtube_tags"].Value = ExtractArray(jsonString, "youtube", "tags", ", ");

    // ==========================================
    // 2. Instagram
    // ==========================================
    project.Variables["instagram_caption"].Value = ExtractField(jsonString, "instagram", "caption");
    project.Variables["instagram_hashtags"].Value = ExtractArray(jsonString, "instagram", "hashtags", " ");

    // ==========================================
    // 3. TikTok
    // ==========================================
    project.Variables["tiktok_caption"].Value = ExtractField(jsonString, "tiktok", "caption");
    project.Variables["tiktok_hashtags"].Value = ExtractArray(jsonString, "tiktok", "hashtags", " ");

    // ==========================================
    // 4. Facebook
    // ==========================================
    project.Variables["facebook_text"].Value = ExtractField(jsonString, "facebook", "text");

    project.SendInfoToLog("JSON успешно распарсен, все переменные распределены.", true);
    return "ok";
}
catch (Exception ex) {
    project.SendErrorToLog($"Ошибка при разборе JSON: {ex.Message}", true);
    return "error";
}
6.2. Копирование обложки в папку конкретной площадки (блоки 6–11)
Приложенный пример жёстко указывает youtube как целевую площадку (targetDir = .../Публикация по площадкам/youtube/thumbnails) — в остальных четырёх цепочках блока 6 используется та же логика с изменённым targetDir под свою площадку (instagram/covers, TikTok/thumbnails, facebook/thumbnails — по структуре папок, которая уже подробно разобрана в статье про сам модульный конвейер публикации). Обратите внимание на три инженерных детали, ради которых стоит скопировать именно этот код себе, а не писать копирование с нуля:- Явный белый список расширений (imageExtensions) вместо . — копируются только реальные картинки, даже если в исходной папке случайно окажется служебный файл.
- overwrite: true при копировании — повторный прогон с тем же именем файла не упадёт на IOException, а просто обновит файл.
- throw в конце catch — ошибка копирования не проглатывается молча, а уводит выполнение блока по красной ветке, что даёт оркестратору шанс среагировать (например, не создавать to_work без обложки).
C#:
try
{
    // --- ОПРЕДЕЛЕНИЕ ПУТЕЙ ---
    string sourceDir = Path.Combine(project.Directory, "trend_pipeline", "output", "thumbnails");
    string targetDir = Path.Combine(project.Directory, "Публикация по площадкам", "youtube", "thumbnails");

    // Поддерживаемые расширения графических файлов
    var imageExtensions = new HashSet<string>(StringComparer.OrdinalIgnoreCase)
    {
        ".jpg", ".jpeg", ".png", ".webp", ".bmp", ".gif", ".tiff", ".jfif", ".avif"
    };

    // 1. Проверка наличия исходной папки
    if (!Directory.Exists(sourceDir))
    {
        project.SendWarningToLog($"⚠ Исходная папка не найдена: {sourceDir}", true);
        return 0;
    }

    // 2. Создание целевой папки, если её ещё нет
    if (!Directory.Exists(targetDir))
    {
        Directory.CreateDirectory(targetDir);
    }

    // 3. Получение списка всех файлов в исходной папке
    string[] allFiles = Directory.GetFiles(sourceDir, "*.*", SearchOption.TopDirectoryOnly);

    // 4. Фильтрация — оставляем только картинки
    List<string> imageFiles = allFiles
        .Where(file => imageExtensions.Contains(Path.GetExtension(file)))
        .ToList();

    if (imageFiles.Count == 0)
    {
        project.SendWarningToLog($"⚠ В исходной папке '{sourceDir}' не найдено ни одного изображения.", true);
        return 0;
    }

    int copiedCount = 0;

    // 5. Копирование файлов в целевую папку
    foreach (string sourceFilePath in imageFiles)
    {
        string fileName = Path.GetFileName(sourceFilePath);
        string targetFilePath = Path.Combine(targetDir, fileName);

        // Копируем с флагом overwrite: true (перезаписываем, если файл с таким именем уже есть)
        File.Copy(sourceFilePath, targetFilePath, overwrite: true);
        copiedCount++;

        project.SendInfoToLog($"Скопировано: {fileName}", true);
    }

    project.SendInfoToLog($"✅ Успешно скопировано изображений: {copiedCount} из '{sourceDir}' в '{targetDir}'.", true);
}
catch (Exception ex)
{
    project.SendErrorToLog($"❌ Ошибка при копировании изображений: {ex.Message}", true);
    throw; // Уводит выполнение кубика по красной ветке при сбое
}
7. Как настроить {-Variable.kvo_video_in_day-} под свою нишу
В примере дневная квота задана через переменную kvo_video_in_day (10 выполнений за сессию), но это настройка одного конкретного прогона, а не рекомендованное значение. Как её выбирать на практике:
1. Отталкивайтесь от реальной способности площадок принимать контент, а не от возможностей генератора. Конвейер может сделать 50 роликов за ночь физически, но YouTube и TikTok есть смысл кормить в темпе, который не выглядит подозрительно для конкретного возраста и истории аккаунта — обычно это единицы публикаций в день на аккаунт, а не десятки.
2. kvo_video_in_day — единственный регулятор темпа всей сессии. Счётчик {-Variable.sch-} — внутренняя служебная переменная, вручную её менять не нужно: она просто отслеживает, сколько роликов уже ушло в работу, а сравнение с квотой происходит в блоке 4. Если нужно, чтобы оркестратор гонял генерацию непрерывно сутками, запускайте его по расписанию, а дневной объём регулируйте именно через kvo_video_in_day и группу «finish»/«очистка проекта залива» в блоке 4.
3. Синхронизируйте с `run.count` самого конвейера. Значение, которое оркестратор ZennoPoster ожидает получить за один вызов generate_videos, разумно держать равным или кратным run.count/--count из config/settings.yaml конвейера (раздел 4.5) — иначе оркестратор либо будет ждать файлов, которых ещё нет, либо не успеет забрать всё, что конвейер уже сгенерировал.
4. Учитывайте `trends.journal.retention_days`. Если дневная квота kvo_video_in_day требует больше уникальных тем в день, чем реально предлагают включённые источники трендов, конвейер начнёт упираться в exhaustion_retry (раздел 4.4) — стоит либо снизить темп, либо включить больше источников трендов (google_trends, youtube_trending, news_api — раздел 4.2 README), либо увеличить retention_days вплоть до повторного использования тем.
8. Гибкость и альтернативные пути связи
Файловый триггер to_work/ready.txt/lose.txt — самый простой и надёжный вариант связи между оркестратором и пятью издателями именно потому, что не требует поднимать сервер или разбираться с сетевой доступностью. Но сама архитектура «сигнал → работа → отчёт» не привязана к файлам:| Транспорт | Когда предпочтителен | Что меняется в логике |
|---|---|---|
| Общая папка (.txt-файлы) | Все процессы на одном ПК или с общей сетевой папкой | Ничего — это базовый вариант из раздела 5 |
| HTTP-сервер на ПК (Flask/FastAPI) | Оркестратор и издатели — на разных, не связанных общей папкой машинах | Издатель опрашивает GET /task вместо чтения файла, отчитывается POST /result |
| Очередь сообщений (RabbitMQ/Redis Queue) | Много издателей, нужна гарантия «ровно один раз» и повторная попытка при сбое | to_work становится сообщением в очереди, а не файлом; издатель — воркер-подписчик |
| Прямая база данных вместо очереди файлов | Нужна история/аналитика по каждой публикации, а не только текущее состояние | output_video/output_metadata — таблицы, а не папки со списками строк |
Практическая рекомендация та же, что и в других кейсах серии: начинать с файлового варианта — он реализуется за час, отлаживается визуально (можно просто открыть папку и увидеть, застрял ли процесс на конкретном шаге) и переживает перезапуск любой из сторон без потери состояния.
9. Как улучшать и применять по-новому
9.1. Вынести квоту kvo_video_in_day в конфиг ниши
Значение kvo_video_in_day живёт в переменной проекта, но сам проект orcestrator у всех ниш один. Для сетки из нескольких ниш (раздел 3.1) удобнее передавать квоту внешним параметром — например, держать рядом с config/settings.yaml каждой ниши собственный маленький файл параметров оркестратора и подставлять его значение во входную переменную проекта при запуске по расписанию. Тогда под каждую нишу правится один файл, а не сценарий.
9.2. Учитывать фактический результат публикации, а не только факт отправки
Сейчас цикл «ожидание конца предыдущей загрузки» (блок 5) реагирует на ready.txt/lose.txt, но дальнейшая судьба ролика (собрал ли он охваты, не улетел ли в теневой бан) оркестратору неизвестна. Логичное развитие — писать в lose.txt/отдельный отчётный файл не только факт успеха/ошибки публикации, но и, где возможно, метрики через API площадки, и использовать их для автоматической паузы конкретного аккаунта, а не только конкретной попытки.
9.3. Балансировка тем между нишами, а не только уникальность внутри одной
topics_journal.json (раздел 4) не даёт повториться теме внутри ОДНОГО прогона конвейера. Если несколько экземпляров всей системы (несколько ниш, раздел 3.1) используют разные, но пересекающиеся источники трендов, есть смысл делить общий журнал между нишами — чтобы «горячая» тема не оказалась одновременно и в финансовом паблике, и в паблике цитат.
9.4. Централизованная панель состояния всех шести проектов
Сейчас состояние системы — это состояние файлов на диске, которое видно только через проводник. Простой скрипт (Python или PowerShell), раз в минуту читающий содержимое всех to_work/ready.txt/lose.txt по пяти площадкам и sch/kvo_video_in_day оркестратора, и выводящий их в одну сводную таблицу или веб-страницу, ничего не меняет в самой архитектуре, но резко сокращает время, нужное человеку, чтобы понять, что сейчас происходит во всех шести запущенных проектах ZennoPoster одновременно.
9.5. Перенести копирование обложки на уровень конвейера
Сейчас копирование обложки (раздел 6.2) продублировано пять раз — по одному разу на площадку, с разным targetDir. Поскольку сама логика (список расширений, overwrite, throw) идентична, её можно вынести в один параметризованный сниппет, принимающий имя площадки как входную переменную, вместо пяти почти одинаковых копий кода на холсте.
10. Итог
Разница между «скриптом, который что-то генерирует» и «инженерной системой» — не в количестве использованных технологий, а в том, что происходит, когда что-то идёт не так и как система запускается заново после перерыва. Здесь шесть независимых процессов ZennoPoster (пять издателей + один оркестратор) не нужно запускать в строгом порядке и не нужно держать в синхронизированном состоянии — каждый может стартовать, останавливаться и перезапускаться в любой момент, потому что вся координация между ними живёт не в оперативной памяти какого-то главного процесса, а на диске, в виде простых текстовых файлов.
Именно поэтому такую архитектуру можно спокойно доверить cron-у или ручному запуску по мере надобности: не потому что она никогда не ошибается, а потому что она умеет ошибаться локально — сбой генерации не трогает уже готовые к публикации ролики, простой одного издателя не тормозит остальные четыре, а перезапуск оркестратора не заставляет заново настраивать пять параллельно работающих проектов, которые всё это время просто ждали своего сигнала.
Именно поэтому такую архитектуру можно спокойно доверить cron-у или ручному запуску по мере надобности: не потому что она никогда не ошибается, а потому что она умеет ошибаться локально — сбой генерации не трогает уже готовые к публикации ролики, простой одного издателя не тормозит остальные четыре, а перезапуск оркестратора не заставляет заново настраивать пять параллельно работающих проектов, которые всё это время просто ждали своего сигнала.
Вложения
Последнее редактирование: